对话生成工作流
直接用自然语言描述任务,生成 workflow.json、节点脚本和入口代码。
Positioning
如果你希望把“提出需求 → 生成工作流 → 启动服务 → 在对话中运行”串成一条连续链路, FlowX 就是这条链路的 MCP 入口。它同时可以作为一个“工作流进化引擎”: 在每次对话反馈后持续优化节点逻辑、执行路径和产出质量,让工作流越跑越贴近你的真实业务目标。
直接用自然语言描述任务,生成 workflow.json、节点脚本和入口代码。
修改需求后可继续更新节点,并立即重启后端,避免旧版本流程继续运行。
支持 stdio 和 Streamable HTTP,便于接入本地 Agent 或常驻远程服务。
可以查看输入格式、执行工作流步骤,并拿回结果、文件或图像用于后续对话。
Compiler Toolchain
下面五个工具覆盖了从创建、修改到重载和执行工作流的常见核心操作。
根据自然语言需求直接生成一个新的工作流目录、配置和节点代码。
按新的修改提示更新指定节点及相关工作流文件,适合持续迭代。
在文件更新后快速重载后端,让最新工作流立即生效。
把聊天输入送入工作流执行一步,并返回当前步骤结果。
查看当前服务器已识别的工作流列表,方便切换和确认目标。
Usage
本地 MCP 配置示例
下面是一个精简版的本地 stdio 配置,适合快速验证。
{
  "mcpServers": {
    "flowx": {
      "url": "http://www.flowxpro.cn/mcp",
      "headers": {
        "Authorization": "Bearer "
      }
    }
  }
}
Pricing
按百万 tokens 计费,基础版本按 4 元人民币起算,支持区分缓存命中、缓存未命中以及输出 tokens 的峰谷时段价格。
Showcase
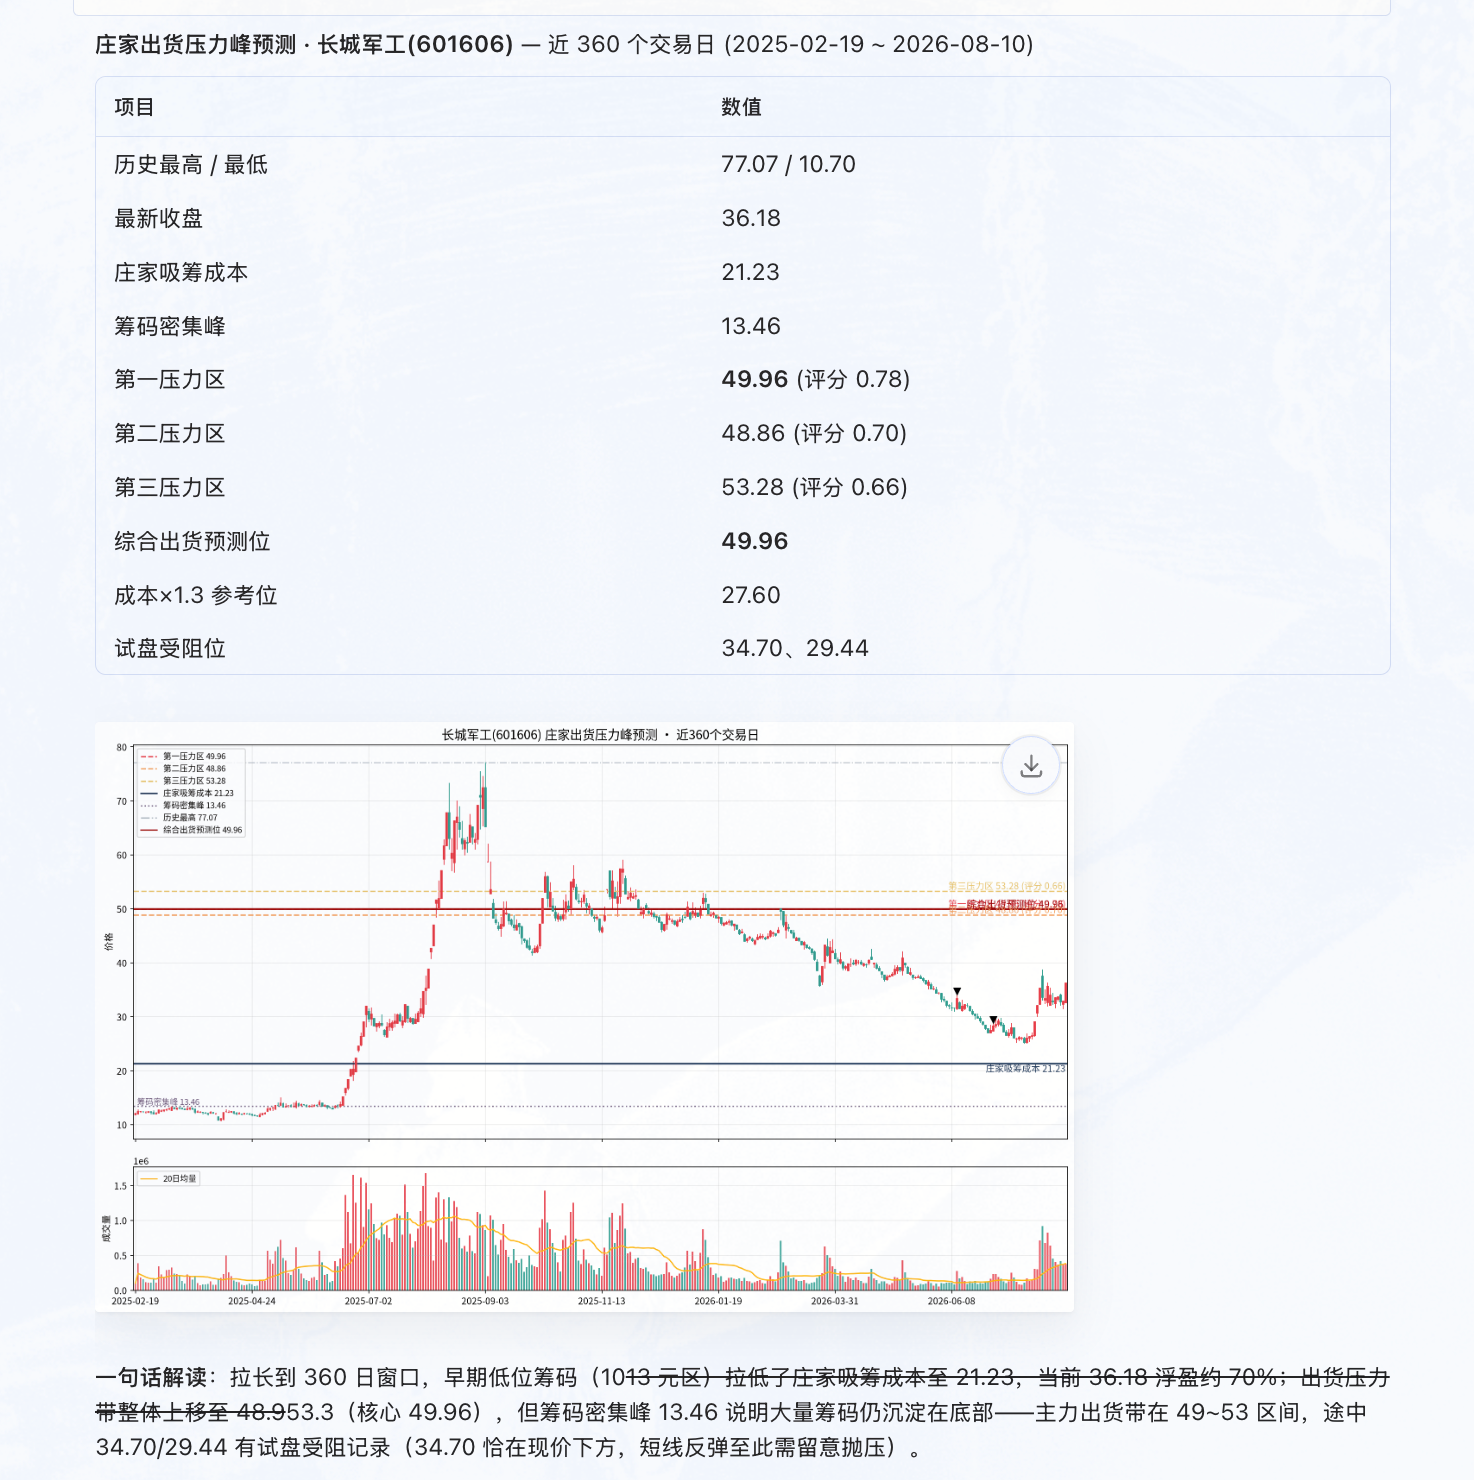
stock_pressure
根据最近 N 个交易日的价格、成交量和筹码分布,推断多个潜在出货压力区, 并把关键参考位画到图上。
使用 flowx-remote 创建一个名字是 stock_pressure 的工作流。

根据下述理论构建一个工作流,根据最近 n 个交易日(用户指定)计算出指定股票(用户指定)庄家未来可能出货的价格位置,并在图表上显示。

庄家出货压力峰预测理论模型

一、模型目标

根据历史成交数据、筹码分布、庄家成本和历史高点信息,寻找未来可能形成出货压力的价格区域。

核心假设:
1. 庄家在股价大跌后低位吸筹。
2. 吸筹阶段形成庄家平均成本区。
3. 后续拉升过程中,庄家通过试盘测试上方卖压。
4. 历史大量成交区域和前期高点会形成动态压力。
5. 出货压力点由多因素共同决定。

二、输入数据

每日行情:
Date: 日期
Open: 开盘价
High: 最高价
Low: 最低价
Close: 收盘价
Volume: 成交量

三、筹码分布模型

将价格区间划分为 N 个价格桶。

对于每个价格区间 p:
C(p)=Σ Volume(t)

其中:
C(p) 表示该价格区域累计成交筹码数量。

成交峰值:
P_peak = argmax C(p)

表示市场成本最密集区域。

四、庄家吸筹成本估计

选择吸筹阶段:

条件:
1. 股价经历大幅下跌。
2. 成交量明显放大。
3. 股价进入横盘震荡。

庄家平均成本:
C_dealer = Σ(P_t × V_t) / ΣV_t

其中:
P_t: 成交价格
V_t: 成交量

得到庄家主要持仓成本。

五、历史压力峰计算

定义压力评分:
Pressure(p)= w1C(p) + w2High_Test(p) + w3Profit(p) + w4Gain(p)

其中:
1. 成交密集压力 C(p)
表示该价格区域历史交易筹码数量。

2. 历史高点压力 High_Test(p)
统计:
- 历史是否出现过高点
- 是否多次冲高失败
- 是否形成顶部区域

3. 获利盘压力 Profit(p)
计算:
Profit(p)=ΣC(x), x<p

表示当前价格以下有多少筹码处于盈利状态。

盈利筹码越多:
潜在卖压越大。

4. 庄家收益压力 Gain(p)
Gain(p)= (p-C_dealer)/C_dealer

表示庄家在该价格位置的理论收益。

六、压力峰搜索算法

步骤1:
建立价格-成交量矩阵:
price_bins = divide(min_price,max_price,N)

步骤2:
统计:
volume_profile[p]

步骤3:
计算每个价格位置:
Pressure Score

步骤4:
排序:
Score 最高的位置作为第一压力峰。

输出:
Pressure_1
Pressure_2
Pressure_3

分别代表:
第一压力区
第二压力区
第三压力区

七、动态试盘验证

庄家拉升过程中观察:

情况 A:
价格上涨,成交量下降。
说明:上方阻力较小。

情况 B:
价格上涨,成交量突然放大,同时出现长上影线,随后回落。
说明:该价格区域存在大量卖盘。

定义:
P_pressure = 当前测试失败价格

八、综合出货价格模型

最终预测:
P_exit = argmax Pressure(p)

即:
最大压力评分对应价格。

实际计算:
P_exit ≈ 庄家成本 × (1+r)

并且:
接近历史成交峰。

其中:
r: 庄家目标收益率。

九、Python 实现思路

输入:
K 线数据 DataFrame

计算:
1. 计算成交量分布
2. 估计庄家成本
3. 寻找历史高点
4. 计算盈利筹码比例
5. 计算 Pressure Score
6. 输出压力峰

伪代码:
for price in price_bins:
        score = (
                w1 * volume_density(price)
                + w2 * historical_high(price)
                + w3 * profit_ratio(price)
                + w4 * dealer_gain(price)
        )

rank(score)

return top_pressure_prices

十、最终解释

庄家未来可能出货的位置,不是简单的历史最高价。
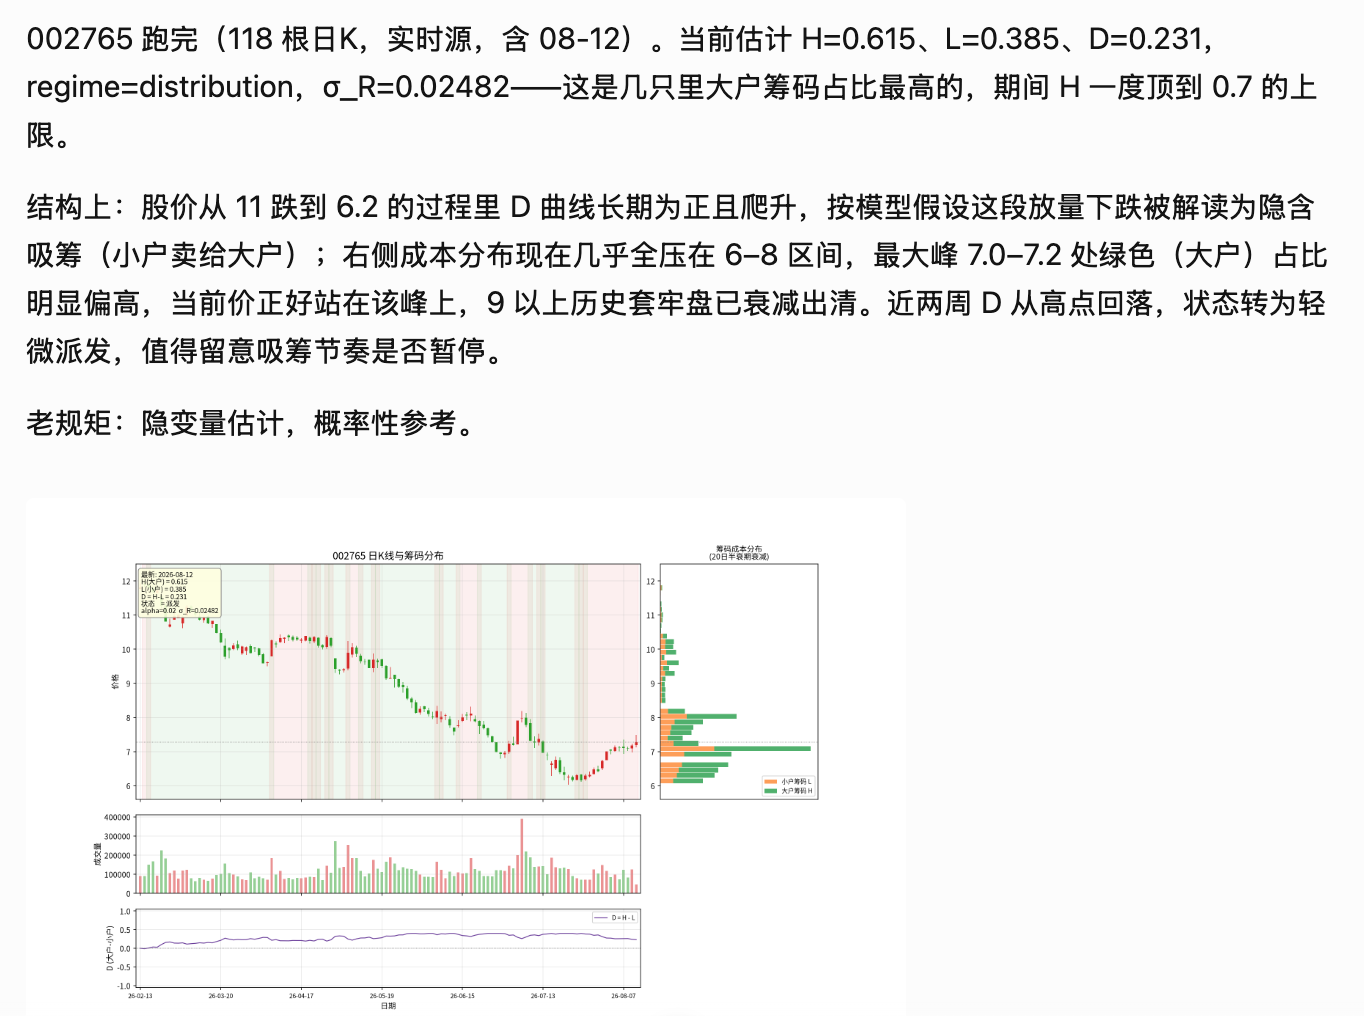
stock_distribution
把价格和成交量转换成隐含大户/小户筹码状态,用图表解释吸筹、派发和成本峰。
使用 flowx-remote 创建一个名字是 stock_distribution 的工作流。

根据如下理论构建一个可以预估当前和历史价格大小户筹码分布并画成图的工作流。

## 角色
你是一名量化研究员,负责根据 1 小时级 OHLCV 数据建立“隐含大小户筹码状态”模型,并识别吸筹、派发与潜在价格压力峰。

## 重要原则
1. 只有价格和成交量时,无法直接观测真实账户的大户/小户持仓。
2. large_ratio / small_ratio 是模型隐变量估计,不是真实账户持仓。
3. “上涨=大户卖给小户、下跌=小户卖给大户”是待检验假设,而不是事实。
4. 所有实时特征只能使用当前及过去数据,禁止未来函数。
5. 输出概率/置信度,不把模型结果描述成确定事实。

## 输入
CSV 至少包含:
datetime, open, high, low, close, volume

## 核心状态
H_t:估计大户筹码比例
L_t:估计小户筹码比例
H_t + L_t = 1
D_t = H_t - L_t = 2H_t - 1

R_t = (P_t-P_{t-1})/P_{t-1}
V*_t = V_t / EMA(V_t)

## 状态转移
最简可校准模型:

ΔH_t = -alpha * tanh(R_t / sigma_R) * V*_t

并限制 H_t ∈ [h_min, h_max]。

解释:
- 放量上涨:模型倾向 H 下降,即“大户→小户”的隐含分散;
- 放量下跌:模型倾向 H 上升,即“小户→大户”的隐含聚合;
- 小波动/正常成交:状态变化较小。
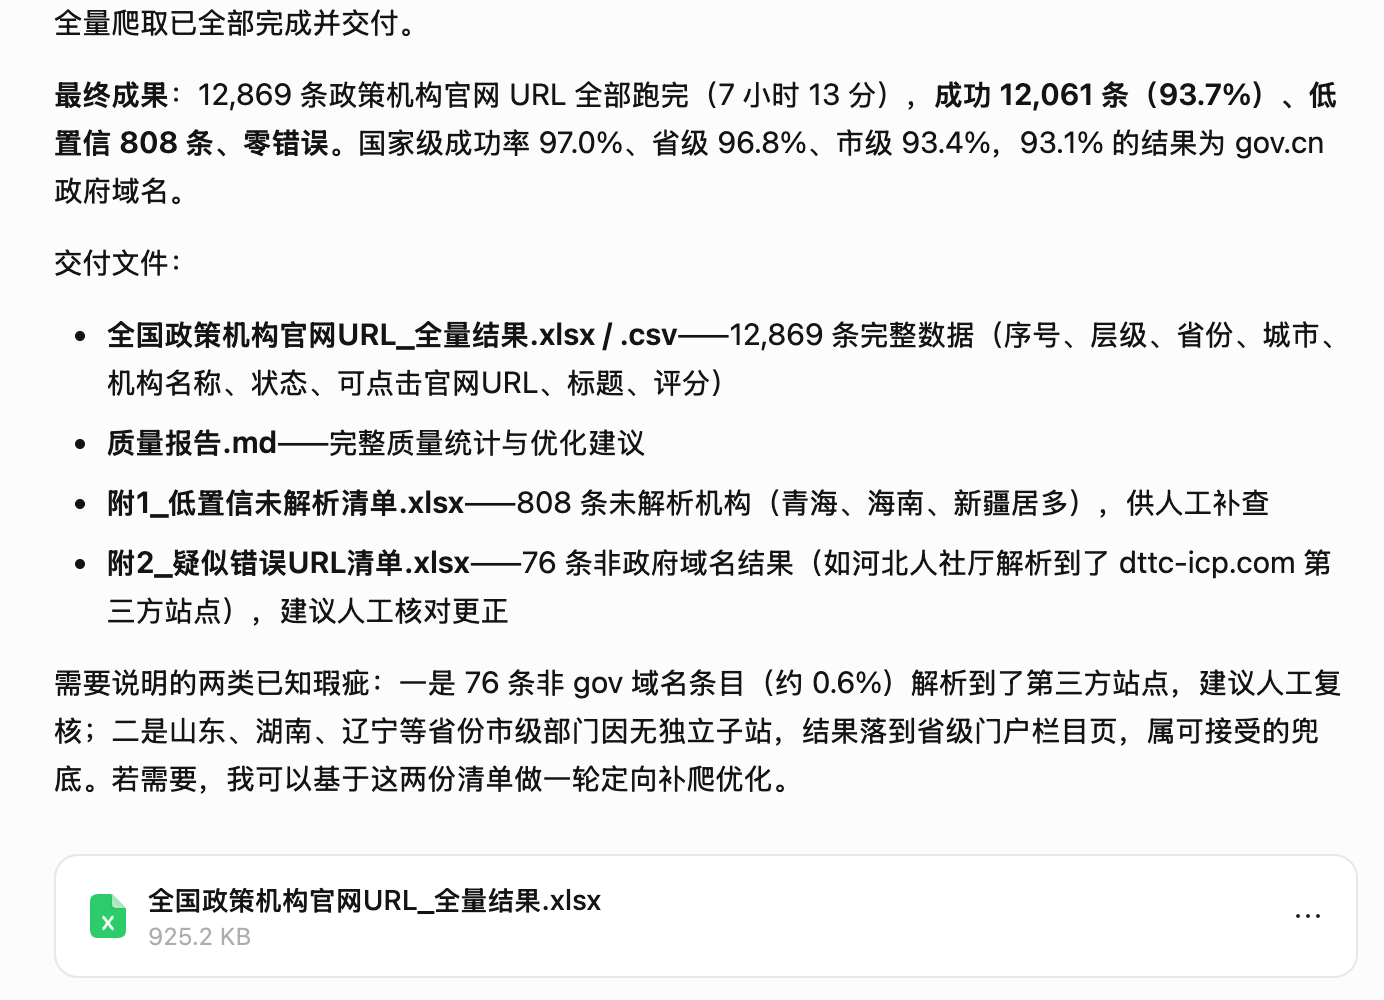
policy_scrawler
结合地域、机构模板和浏览器搜索,批量收集全国政策机构官网 URL 并给出质量结果。
使用 flowx-remote 创建一个名字是 policy_scrawler 的工作流。

要求:
1. 从全国政策发布机构名录获取需要的机构名称模版。
2. 结合全国省-市-县名称,整理全国政策机构的具体搜索名称。
3. 使用 Playwright 模拟浏览器,在百度搜索对应机构官网名称。
4. 构建一个可以爬取全国政策机构官网 URL 的工作流。
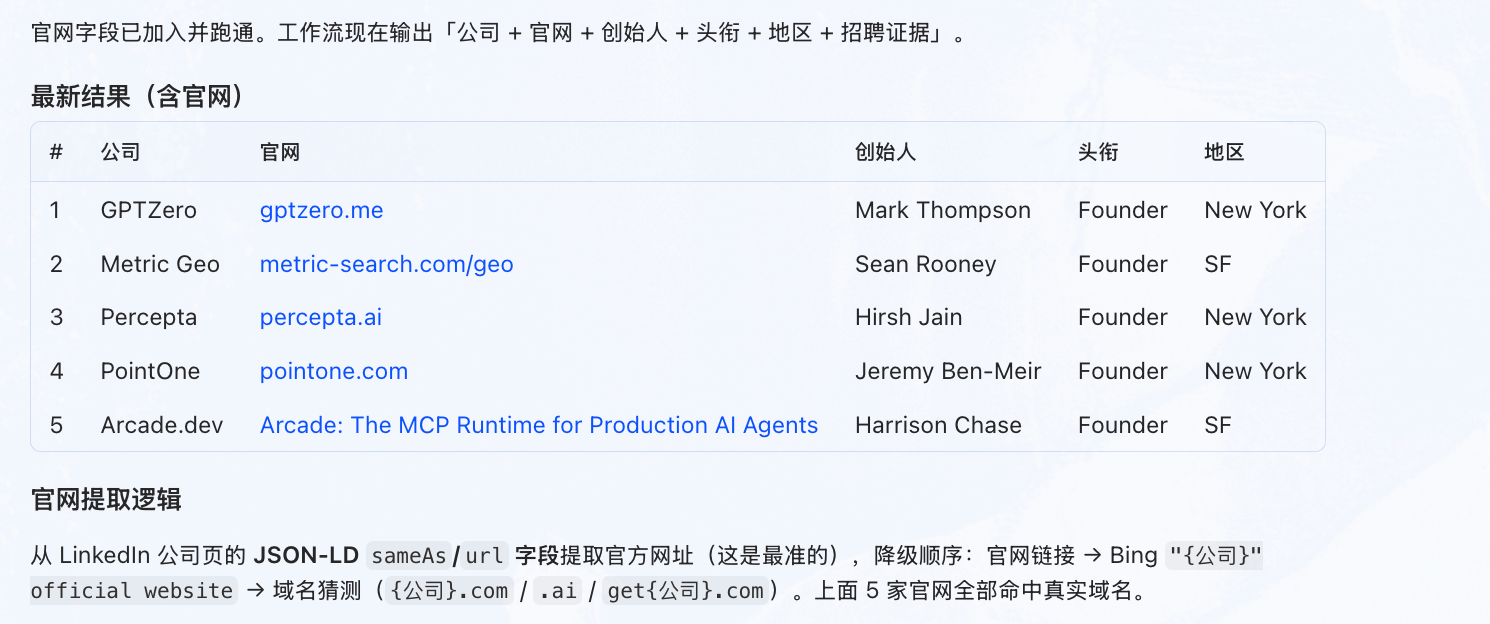
start-up-hiring
从 LinkedIn 等来源整理正在招聘的 AI Startup、官网、创始人、头衔和地区信息。
flowx-remote-us帮我构建一个到LinkedIn上找n个正在招人的AI startups的创始人的爬虫工作流
picture_to_svg
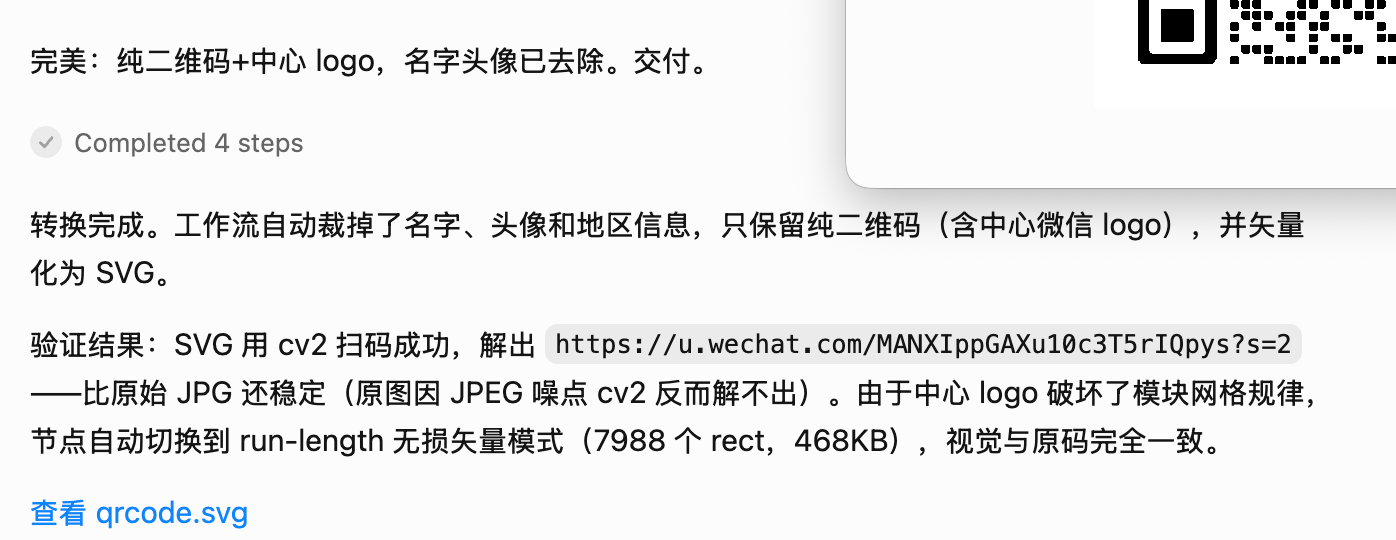
上传微信二维码图片,自动去除姓名、头像等信息,并导出为更干净的 SVG 文件。
使用 flowx-remote 创建一个名字是 picture_to_svg 的工作流。

创建一个上传微信二维码图片、自动去除人名信息并转成 SVG 格式的工作流。
Contact
你可以直接发邮件,或通过微信二维码联系作者。